
В OpenAI Cookbook появился разбор по модели gpt-image-1.5: как генерировать изображения «под задачу», а не просто «красиво». Гайд закрывает больные места — читаемый текст в кадре, сохранение стиля при правках, аккуратные вырезки товара, контролируемую композицию.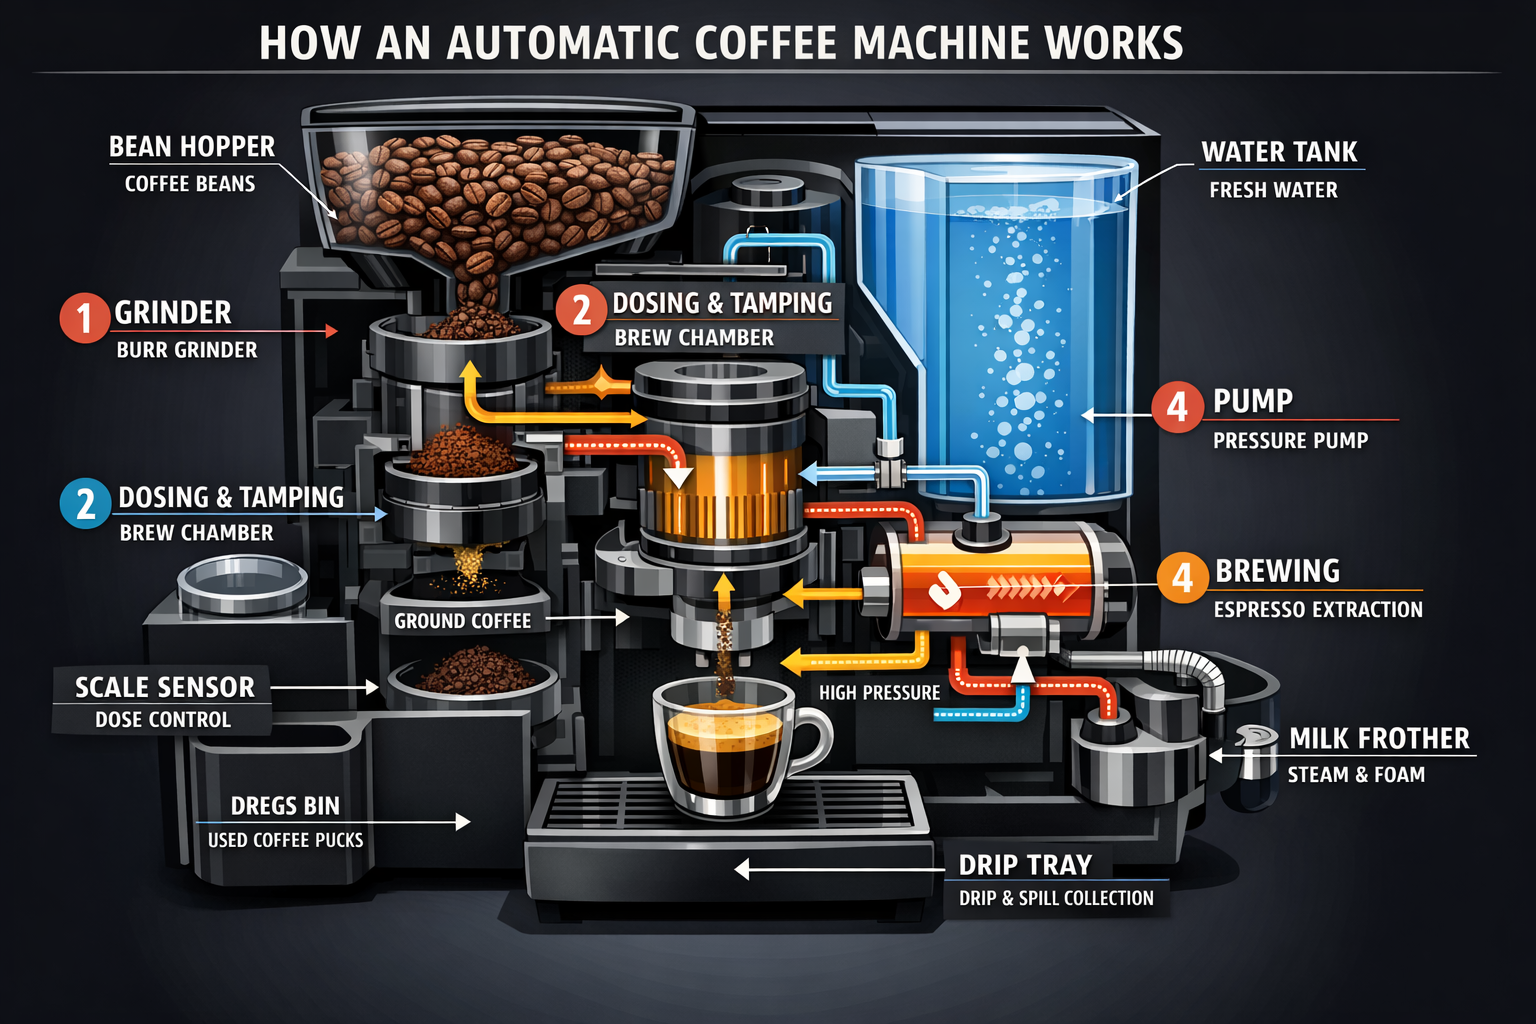
Кто, что, когда и где
Кто: OpenAI (авторы гайда — команда OpenAI и соавторы).
Что: практическое руководство по двум режимам — «текст → изображение» и «текст + изображение → изображение».
Когда: 16 декабря 2025 года (дата публикации гайда).
Где: OpenAI Cookbook и документация OpenAI API (Image generation).
Зачем: чтобы получать повторяемый результат для дизайна, маркетинга, интерфейсов и контента.
Почему «промпт» — это не поэзия, а ТЗ
Когда вы просите конкретику, модели часто «додумывают»: добавляют лишние детали, меняют стиль на ходу, портят надписи. Cookbook предлагает лечить это дисциплиной запроса: структура + ограничения + маленькие итерации.
Базовый порядок такой: фон/сцена → объект → детали → ограничения → цель (зачем картинка). Если задача сложная, лучше короткие помеченные блоки, чем один длинный абзац.
Шесть приёмов, которые сильнее всего влияют на результат
Композиция словами. Ракурс и кадрирование важнее магического «8K»: «вид сверху», «средний план на уровне глаз», «негативное пространство слева под текст».
Ограничения в явном виде. «Без водяных знаков», «не добавлять логотипы/товарные знаки», «не менять раскладку», «сохранить геометрию».
Текст внутри изображения. Рекомендуют писать буквальный текст в кавычках и задавать типографику (шрифт, размер, цвет, место). Сложные слова — проговаривать по буквам.
Итерации «по одному винтику». Вместо переписывания промпта: «сделай свет теплее», «убери лишний объект», «верни фон как был». И каждый раз повторять, что нельзя трогать.
Мульти‑референсы. Если у вас несколько входных картинок, их лучше подписывать: «Изображение 1 — товар, Изображение 2 — стиль», и отдельно сказать, что именно переносим.
Качество как ручка скорости. Для поточных задач советуют начинать с quality="low", а финал и плотный текст делать на high.
Что можно генерировать с нуля: примеры из гайда
Инфографика и схемы — вплоть до «визуальных вики» и таймлайнов. В руководстве приводят пример схемы устройства кофемашины; для плотных макетов рекомендуют high.
Логотипы — через ограничения бренда: простой силуэт, отрицательное пространство, читаемость в маленьком размере. Плюс можно сразу получить несколько вариантов (параметр n).
UI‑макеты — если описывать интерфейс как «уже существующий продукт», а не как концепт‑арт: тогда получается более реалистичная сетка, иерархия и типографика.
Режим правок: стиль, примерка, товарные карточки и «не трогай остальное»
Style transfer нужен, когда вы хотите сохранить визуальный язык референса (палитра, фактура, зерно), но поменять сюжет. Ключ — прямо разделить: что меняем, а что сохраняем, и запретить «добавлять от себя».
Виртуальная примерка одежды строится на «заморозке личности»: не менять лицо, пропорции, позу, волосы — заменить только одежду, с правдоподобными складками и тенями.
Для маркетплейсов важен кейс «вырезать товар»: прозрачный фон (PNG), чёткий контур без ореолов и сохранение читаемости этикетки.
Ещё один практичный трюк — перевод текста внутри изображения, не ломая макет: меняется только надпись, всё остальное остаётся на месте.
Пара технических деталей, которые экономят нервы
В API можно выбирать размер (например, 1024×1024, 1536×1024, 1024×1536), формат (PNG/JPEG/WebP) и даже включать потоковую выдачу частичных кадров. Для прозрачного фона достаточно указать background=transparent и оставить PNG/WebP.
Сколько это стоит
По странице цен OpenAI ориентир для одного квадратного изображения такой: около $0.01 на low, $0.04 на medium и примерно $0.17 на high. Итог зависит от настроек и размера, но как правило самый заметный рычаг — выбор качества.
ПОХОЖИЕ НОВОСТИ