HPE 3PAR для виртуализации: зачем виртуальным машинам отдельная СХД
Когда десятки виртуальных машин работают на нескольких физических серверах, размещение их данных влияет на обслуживание и доступность всей инфраструктуры. Если виртуальные диски хранятся только локально, перенос VM на другой хост требует также переноса данных либо заранее настроенной репликации. Общая СХД отделяет хранение от вычислительных узлов: несколько серверов получают доступ к дисковым ресурсам, что упрощает миграцию VM и обслуживание хостов. На примере массивов HPE 3PAR разберем, как устроена такая архитектура, какие задачи она решает и когда локальных накопителей достаточно.
Где хранятся данные виртуальных машин
У виртуальной машины есть виртуальные диски, конфигурация и служебные файлы. Её CPU и RAM выделяются из ресурсов физического хоста, а данные размещаются на накопителях. Поэтому при проектировании инфраструктуры нужно отдельно определить, где будут храниться VM и какие серверы получат доступ к этому хранилищу.
Для начала сравним два варианта размещения данных.
-
Локальные накопители сервера. Виртуальные диски находятся на HDD, SSD или NVMe внутри конкретного хоста. Такая конфигурация не требует отдельной сети хранения и может обеспечивать высокую производительность. Однако при недоступности сервера другой узел не получает автоматического доступа к его накопителям. Для восстановления работы потребуются дополнительные механизмы, например репликация или восстановление из резервной копии.
-
Отдельная общая СХД. Накопители размещаются в самостоятельном массиве, который предоставляет дисковые ресурсы нескольким хостам. Вычисления выполняются на серверах, а данные VM остаются на общем хранилище. При корректной настройке кластера это позволяет переносить выполнение виртуальной машины между узлами без копирования её виртуальных дисков.
Общий доступ при этом должен координироваться гипервизором и кластерными механизмами: простого подключения одного тома к нескольким серверам недостаточно. Выбор между двумя вариантами определяется требованиями к обслуживанию, доступности и масштабированию. Само по себе внешнее размещение накопителей еще не гарантирует ни большей скорости, ни отказоустойчивости.
Что меняется при использовании общей СХД
Предположим, на трёх физических серверах работают 30 виртуальных машин. Один хост нужно отключить для замены компонентов. Если данные VM находятся на общем хранилище, их виртуальные диски можно оставить на месте, перенеся выполнение машин на два оставшихся сервера. Для этого нужны настроенная живая миграция, совместимость хостов и достаточный запас CPU и RAM на принимающих узлах.
Разделение вычислений и хранения даёт администратору несколько практических возможностей.
-
Плановое обслуживание хостов. Виртуальные машины перемещают на другие узлы перед отключением сервера. При соблюдении требований гипервизора живая миграция позволяет выполнить такой перенос без остановки гостевой ОС;
-
Перераспределение нагрузки. VM можно переместить на менее загруженный сервер без переноса ее виртуальных дисков. Однако перегрузку самого массива такая миграция не устранит: запросы продолжат поступать в прежнее хранилище;
-
Централизованное управление емкостью. Дисковые ресурсы выделяют из общего пула, поэтому свободное место не остается привязанным к отдельному вычислительному узлу. При этом администратор должен контролировать как доступную ёмкость, так и суммарную нагрузку.
Плановую миграцию нужно отличать от восстановления после аварии. Если хост внезапно отказал, настроенный HA-кластер может перезапустить его VM на оставшихся узлах, но такой перезапуск сопровождается простоем. Общая СХД обеспечивает доступ к данным; обнаружение отказа и запуск машин выполняют кластерные механизмы. Доступность самого массива и путей подключения к нему становится общим требованием для всех обслуживаемых VM.
Как HPE 3PAR работает в виртуальной инфраструктуре
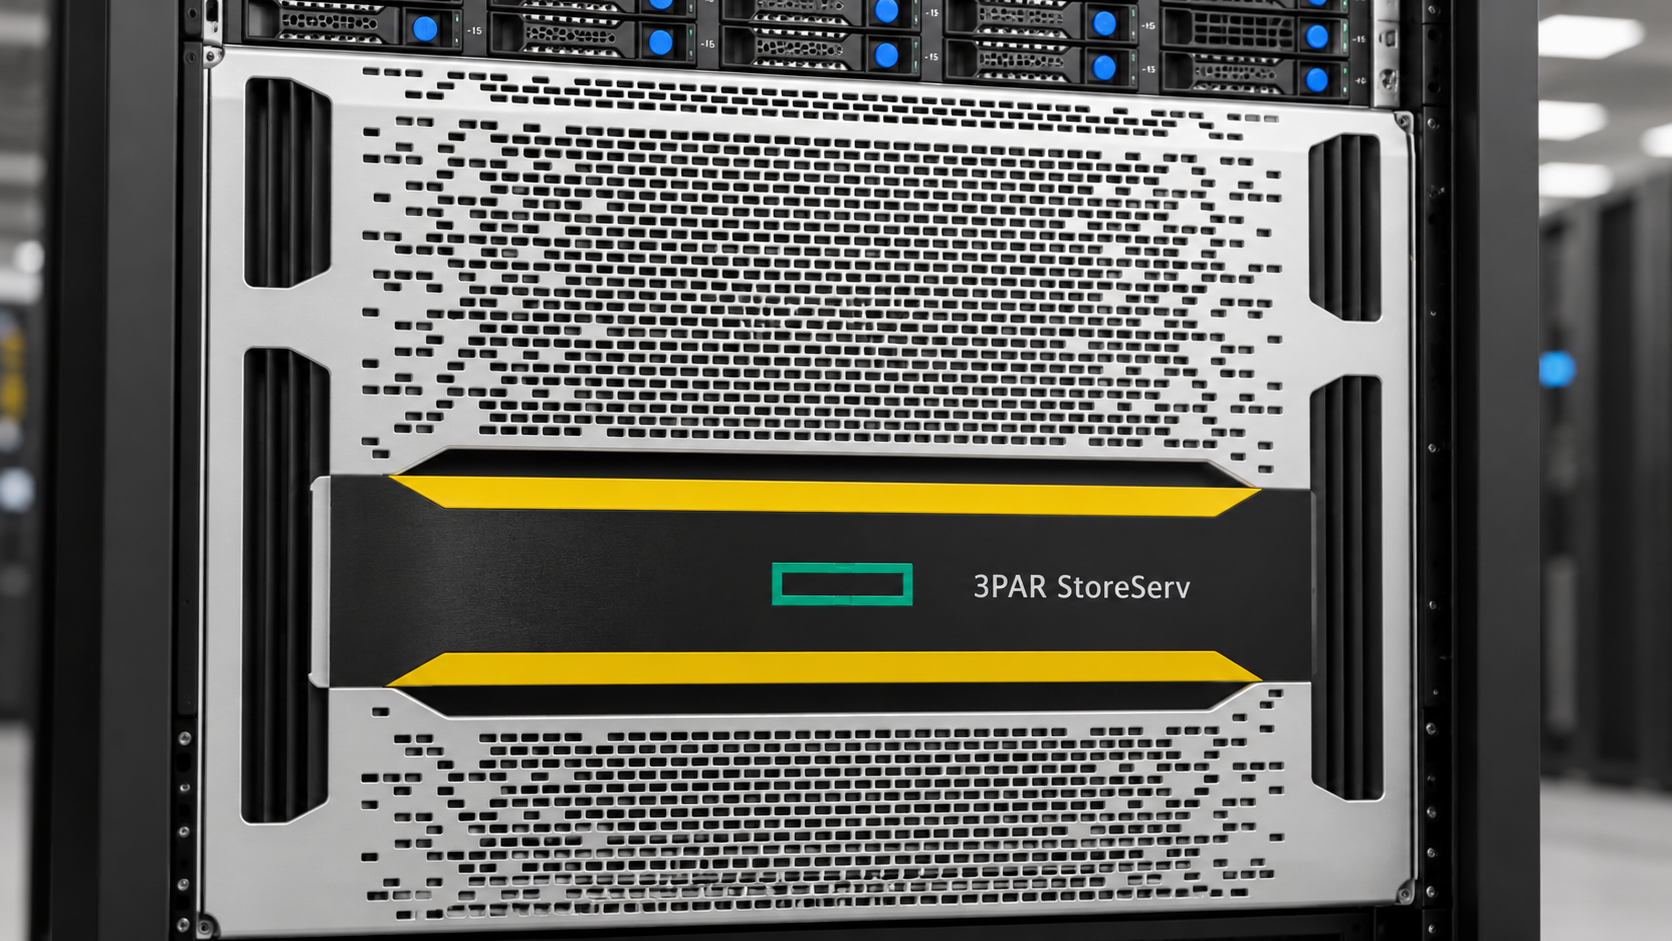
HPE 3PAR StoreServ — линейка корпоративных массивов, предоставляющих серверам централизованные дисковые ресурсы. Вычислительные узлы подключаются к массиву через сеть хранения и получают доступ к выделенным логическим томам. В такой архитектуре гипервизор управляет виртуальными машинами, а массив обслуживает операции чтения и записи.
Путь от физических накопителей до диска внутри VM включает несколько уровней.
-
Массив предоставляет тома хостам. Администратор создаёт виртуальные тома 3PAR и экспортирует их выбранным серверам как LUN — логические блочные устройства. Хост видит выделенный ресурс, а размещением данных на физических накопителях управляет массив.
-
Гипервизор организует хранилище VM. Например, в VMware vSphere на предоставленном LUN можно создать datastore с файловой системой VMFS. В кластере Microsoft Hyper-V общие дисковые ресурсы могут использоваться как CSV — кластерные общие тома.
-
Виртуальные машины используют свои диски. Файлы виртуальных дисков размещаются в подготовленном хранилище, а гостевые ОС обращаются к ним через виртуальные контроллеры. Один массив при этом обслуживает несколько физических хостов.
При сравнении конфигураций HPE 3PAR нужно учитывать не только емкость накопителей, но и состав контроллеров, интерфейсы подключения и версию 3PAR OS. Совместимость с VMware или Hyper-V проверяют для конкретной модели массива, выпуска гипервизора, адаптеров и драйверов по матрице HPE SPOCK. Поддержка платформы виртуализации на уровне линейки не гарантирует совместимости любой комбинации оборудования и ПО.
Fibre Channel и iSCSI: как серверы подключаются к 3PAR
Для доступа к дисковым ресурсам массива используют Fibre Channel или iSCSI — в зависимости от модели и установленных интерфейсов. В обоих случаях сервер получает блочное устройство, на котором гипервизор организует хранилище виртуальных машин. Различается транспорт, по которому передаются команды чтения и записи.
Fibre Channel предполагает специализированную сеть хранения с соответствующими адаптерами и коммутаторами. Такой вариант логичен, если в инфраструктуре уже есть FC-фабрика и команда умеет ее обслуживать. Отдельная сеть позволяет изолировать дисковый трафик от обычного Ethernet-трафика серверов.
iSCSI передаёт команды SCSI через TCP/IP и работает поверх Ethernet. Он позволяет использовать привычные сетевые технологии, но требует расчета пропускной способности и контроля перегрузок. Если дисковый трафик конкурирует с резервным копированием или другими интенсивными потоками, задержки могут увеличиваться.
Выбирать протокол только по номинальной скорости порта некорректно. На результат влияют нагрузка VM, возможности массива и вся цепочка подключения. Для обоих вариантов нужны резервные пути доступа: отказ одного адаптера, кабеля или коммутатора не должен отключать хост от общего хранилища.
Почему для виртуализации важна производительность хранилища
Общий массив одновременно обслуживает запросы баз данных, файловых серверов, корпоративных приложений и тестовых VM. Их нагрузка складывается: пока одна система выполняет короткие случайные чтения, другая записывает журнал транзакций, а третья участвует в резервном копировании. Поэтому достаточная ёмкость ещё не означает, что хранилище справится с рабочей нагрузкой.
Оценивать его нужно по трём взаимосвязанным показателям.
-
IOPS — количество операций чтения и записи в секунду. Сравнивать значения можно только с учетом размера блока, соотношения чтения и записи и характера доступа. Показатель для последовательного чтения не описывает поведение массива под смешанной нагрузкой VM.
-
Latency — время выполнения запроса к хранилищу. Рост задержек особенно заметен там, где приложение ждёт завершения дисковой операции, например подтверждения записи журнала транзакций. Среднее значение может скрывать кратковременные, но существенные всплески.
-
Пропускная способность — объем данных, передаваемый за секунду. Она важна при работе с крупными файлами, резервном копировании и восстановлении, но сама по себе не гарантирует быстрого выполнения множества мелких запросов.
Практический ориентир — задержки в периоды максимальной совместной активности VM. Если запуск резервного копирования замедляет рабочую базу, нужно искать ограничение в накопителях, контроллерах или сети хранения. Увеличение числа терабайт без изменения узкого места проблему не решит.
Чем HPE 3PAR интересна именно в виртуальной среде
При большом количестве VM дисковое пространство обычно выделяют с запасом, хотя заполняется оно постепенно. Thin provisioning позволяет предоставлять хостам логические тома, выделяя физическую емкость по мере записи данных. Это сокращает объем заранее занятого пространства, но требует контроля свободного места: обещанная хостам емкость не превращается в физическую автоматически.
Остальные возможности массива помогают управлять производительностью и доступностью общего хранилища.
-
Выбор накопителей под нагрузку. В линейке есть полностью SSD-массивы и модели, допускающие сочетание SSD и HDD. Состав дисков определяет возможности конкретной конфигурации: наличие нескольких SSD не делает весь доступный объем одинаково быстрым.
-
Резервирование компонентов. Контроллерные узлы, питание и пути доступа к накопителям рассчитаны на работу с резервированием. Однако при отказе компонента оставшиеся ресурсы должны справляться с нагрузкой — этот запас учитывают при проектировании.
-
Расширение емкости. Поддерживаемые накопители и дисковые полки позволяют увеличивать доступное пространство в пределах ограничений модели. Расширение требует соблюдения правил комплектации и не устраняет автоматически ограничения контроллеров или интерфейсов.
В сочетании с интеграцией в поддерживаемые среды виртуализации эти функции упрощают эксплуатацию общего пула хранения. Их практическая ценность зависит от конфигурации, версий ПО и доступных лицензий. При этом резервирование внутри массива не заменяет отдельную резервную копию данных.
Когда отдельная СХД действительно нужна
Количество виртуальных машин само по себе не определяет необходимость внешнего массива. Десятки малонагруженных VM могут нормально работать на локальных SSD, тогда как несколько критичных систем требуют кластера с возможностью обслуживания хостов без остановки приложений. Решение зависит от требований к доступности, роста данных и возможностей эксплуатации.
Отдельное общее хранилище оправдано, когда инфраструктуре нужны следующие возможности.
-
Обслуживание нескольких хостов с переносом VM. Вычислительные узлы можно последовательно выводить из работы, сохраняя доступ остальных серверов к данным;
-
Централизованное выделение дисковых ресурсов. Ёмкостью управляют на уровне массива, без необходимости устанавливать накопители в каждый сервер;
-
Раздельное расширение вычислений и хранения. Дополнительный хост подключают к существующим томам, а дисковую емкость наращивают в пределах возможностей массива;
-
Перезапуск VM после отказа хоста. Общая СХД может стать основой для HA-кластера при наличии резервных подключений и достаточных ресурсов на оставшихся узлах.
Для одного сервера, небольшого числа VM и допустимых окон простоя локальные накопители часто проще в эксплуатации и дешевле по совокупным затратам. Внешний массив добавляет расходы на подключение, поддержку и обслуживание.
При этом кластер не обязательно требует отдельной СХД: существуют распределенные хранилища на накопителях самих хостов. Поэтому сравнивать нужно готовые архитектуры с одинаковыми требованиями к доступности и производительности, учитывая также лицензии, резервирование и квалификацию команды.
HPE 3PAR сегодня: новый проект или существующая инфраструктура
HPE 3PAR относится к предыдущим поколениям корпоративных систем хранения. При оценке такой платформы в 2026 году особенно важен жизненный цикл конкретной модели: сроки поддержки оборудования и ПО различаются, поэтому переносить статус одной серии на всю линейку нельзя. Для ряда систем производитель уже опубликовал уведомления о завершении жизненного цикла.
Практический смысл покупки стоит оценивать в двух сценариях: расширение действующей инфраструктуры и приобретение refurbished-массива под определенную нагрузку. В первом случае полезны совместимость с существующим окружением и опыт команды. Во втором экономию нужно считать с учетом обслуживания, энергопотребления, запасных компонентов и будущей миграции.
Перед покупкой проверяют несколько групп параметров.
-
Комплектацию и состояние. Точную модель, контроллеры, интерфейсные платы, дисковые полки, ошибки накопителей и оставшийся ресурс SSD. Обозначение refurbished само по себе не описывает глубину диагностики.
-
ПО и лицензии. Установленную версию 3PAR OS, доступность необходимых функций, документы на лицензии и возможность получения обновлений.
-
Совместимость. Поддерживаемое сочетание массива, гипервизора, адаптеров, драйверов и сетевого оборудования, включая ограничения будущих обновлений.
-
Сервис. Кто устраняет неисправности, какие компоненты доступны для замены и за какое время восстанавливается работоспособность. Гарантию продавца и поддержку производителя оценивают отдельно.
Для нового проекта с длительным сроком эксплуатации низкая цена массива недостаточна. Покупка оправдана, если подтверждены производительность, совместимость и возможность обслуживать систему на всём запланированном сроке.
Итог
HPE 3PAR отделяет хранение данных VM от вычислительных серверов, упрощая миграцию машин и обслуживание хостов. Такая архитектура оправдана для кластерной инфраструктуры, а небольшому автономному серверу часто достаточно локальных SSD или NVMe. При выборе массива нужно оценивать производительность, совместимость и доступность сервиса на весь срок эксплуатации.
Остались вопросы? Задавайте их в комментарии, и мы постараемся ответить на них.
ПОХОЖИЕ НОВОСТИ