Как в Uzum выстроили единую платформу для ML и LLM-разработки
По мере роста AI-направлений компании неизбежно сталкиваются с одной и той же проблемой: моделей становится больше, но процессы их внедрения остаются фрагментированными. Каждая команда выстраивает собственный стек, релизы зависят от конкретных инженеров, а поведение моделей в production сложно контролировать.
С этой ситуацией столкнулась и команда Uzum в момент активного масштабирования AI. Классические ML-модели уже использовались в ключевых бизнес-сценариях, параллельно начали появляться LLM-сервисы. При этом единых стандартов разработки, деплоя и мониторинга не существовало.
Именно в этот момент Денис Чевкота, занимавший позицию Director of Artificial Intelligence, предложил изменить сам подход. Вместо того чтобы продолжать развивать отдельные практики, он инициировал создание единой платформы, которая бы охватывала весь жизненный цикл AI-решений.
Переход к платформенной модели
На старте это была не столько техническая, сколько организационная задача. Нужно было перейти от набора независимых инициатив к единой системе, в которой разработка, релиз и сопровождение моделей становятся повторяемым процессом.
Под руководством Дениса была спроектирована MLOps / LLMOps платформа, которая объединяет работу с классическими моделями и генеративными системами в одной архитектуре. Это решение выглядело нетривиально: на практике в большинстве компаний эти два направления развиваются отдельно, с разными инструментами и подходами.
Здесь же было принято решение сразу строить единый слой, в котором учитываются особенности обоих типов систем.
Единая инфраструктура для разных типов AI
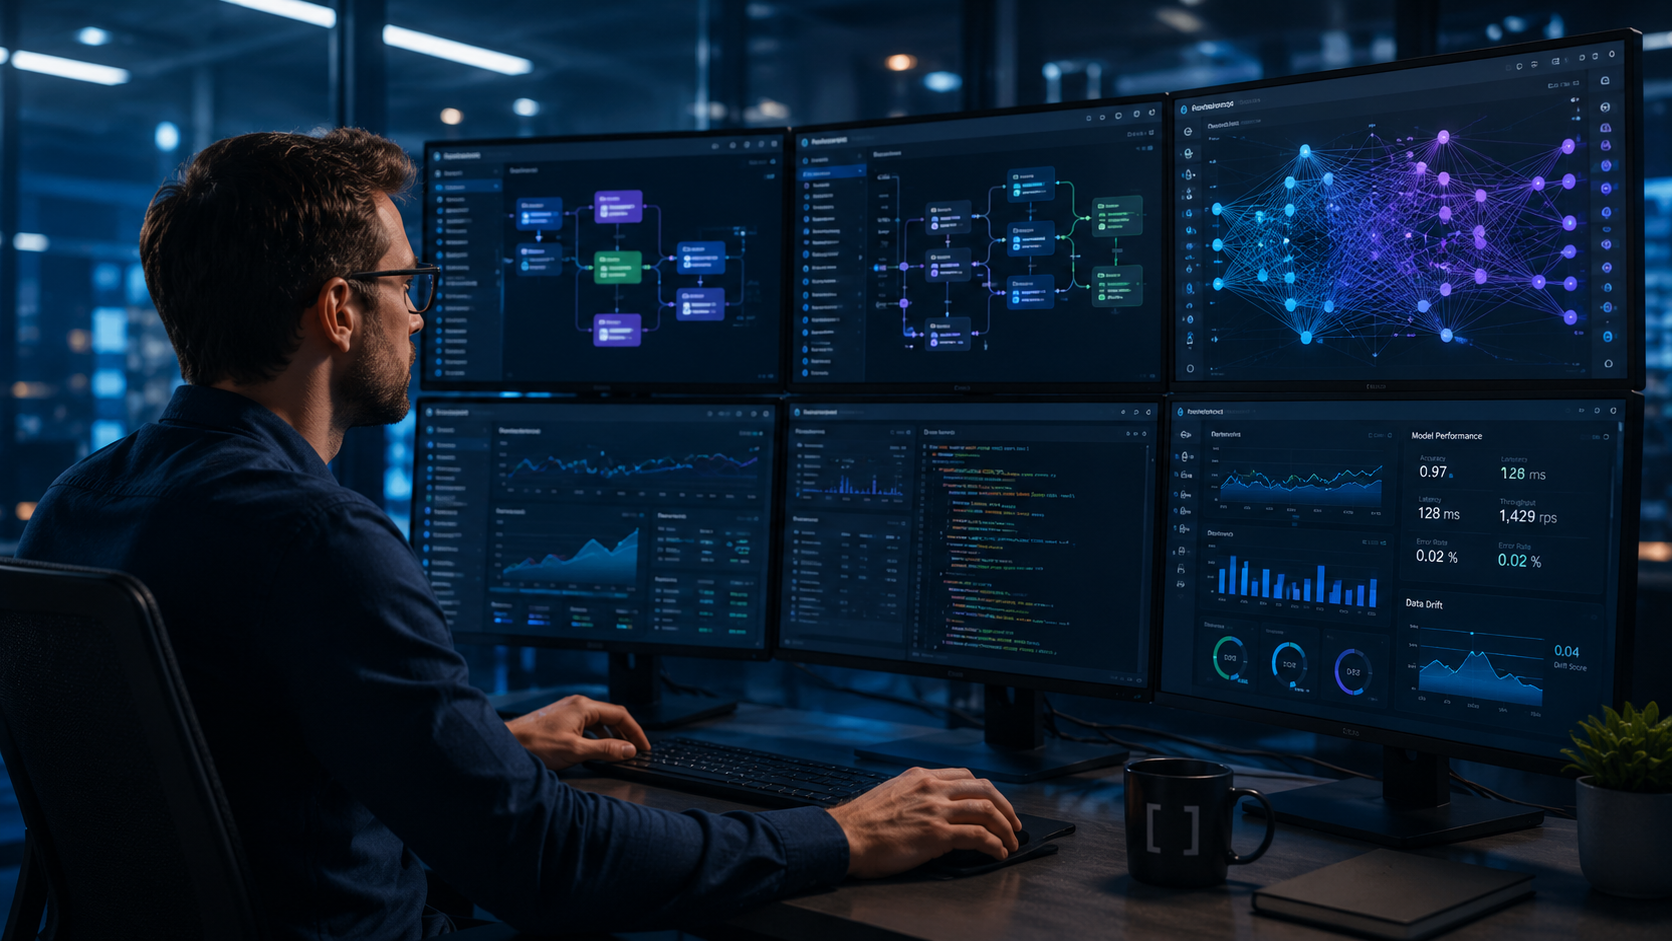
Платформа покрывает полный путь от обучения до эксплуатации. Модели обучаются в воспроизводимых окружениях, проходят валидацию, регистрируются вместе с конфигурациями и затем разворачиваются в production через стандартные процессы.
При этом LLM-сервисы не рассматриваются как исключение. Для них в рамках той же архитектуры были добавлены дополнительные механизмы: управление версиями prompt’ов, контроль retrieval-компонентов, отслеживание качества ответов и сценарии безопасной деградации.
Такой подход позволил избежать типичной ситуации, когда генеративные решения живут отдельно от основной ML-инфраструктуры и со временем становятся сложными в поддержке.
Стандартизация как способ ускорения
Одним из ключевых результатов стало появление единых правил разработки. Если раньше каждая команда собирала pipeline под конкретный кейс, то теперь базовые элементы уже заданы на уровне платформы.
Это изменило экономику разработки. Команды перестали тратить время на сборку инфраструктуры и сосредоточились на самих моделях и продуктовой логике.
В результате время вывода решений в production сократилось, а сами процессы стали более предсказуемыми.
Управление качеством и наблюдаемость
Отдельное внимание было уделено тому, что происходит с моделями после релиза. Платформа включает полноценный слой мониторинга, который позволяет отслеживать не только технические параметры, но и качество работы моделей.
Для классических ML-систем это контроль распределений и стабильности метрик. Для LLM — качество ответов, задержки и поведение retrieval-цепочек.
Это важный момент, потому что именно на этапе эксплуатации часто возникает наибольшее количество проблем, особенно в генеративных системах.
Почему этот подход отличается
Сами по себе инструменты, использованные в платформе, хорошо известны на рынке. Отличие заключается в том, как они были объединены.
Во многих компаниях MLOps существует для классических моделей, а LLM-сервисы развиваются как отдельные эксперименты. Здесь же оба направления изначально были сведены в единую систему с общими стандартами deployment, monitoring и управления изменениями.
Фактически речь идет о переходе от «набора AI-проектов» к модели, где AI становится устойчивой и масштабируемой функцией компании.
Результат для бизнеса
Практический эффект оказался измеримым. Скорость вывода моделей в production выросла, цикл релиза сократился до нескольких дней, а количество эксплуатационных инцидентов снизилось.
Но важнее другое. Появилась возможность масштабировать AI-направление без пропорционального роста сложности.
Роль Дениса Чевкоты в этом проекте заключалась не только в выборе технологий, но и в том, чтобы задать саму модель развития. Платформа была изначально спроектирована как основа для будущих AI-сервисов, а не как решение под конкретные задачи.
Как объединение ML и LLM меняет логику развития AI
В долгосрочной перспективе этот подход задаёт более высокий уровень зрелости работы с AI. В большинстве компаний ML и LLM по-прежнему развиваются как разные технологические ветки: классические модели через MLOps, генеративные системы через быстрые, но изолированные решения. Здесь же эти два слоя изначально сведены в единую управляемую систему с общими правилами разработки, релиза и контроля качества.
Такое объединение меняет саму модель развития AI. Вместо накопления разрозненных сервисов формируется единая среда, где любые новые решения сразу создаются как часть масштабируемой инфраструктуры. На практике это означает, что компания может расти не за счёт увеличения сложности, а за счёт повторяемости и управляемости процессов. Это подход, который пока только начинает формироваться на рынке и редко закладывается на этапе активного роста.
ПОХОЖИЕ НОВОСТИ